

AI时代的能力鸿沟,越拉越大?
一家公司的办公室里,入职半年的年轻人用生成式AI,不到十分钟做完了一份原本要磨一下午的报表,还附带三种备选方案。
镜头转到某城市的一所小学里,孩子们正围着AI做项目、练提问,学着分辨机器给出的答案是否可靠;几百公里外的乡镇学校,学生第一次接触AI,是老师用手机演示“它什么都能答”。
这已经是如今社会中真实的画面。虽然没有刻意的厚此薄彼,但现实是,AI带来的并不是能力的平均化,而是能力的分化。一个高水平的使用者与一个普通使用者之间的差距,并不会因为拥有同样的工具而缩小,反而可能加速扩大。AI更像一面放大镜,把原本潜藏于教育、认知、资源之中的能力鸿沟,快速暴露和放大。
一道门槛:谁摸得着AI
鸿沟,始于裂缝,而接入,是最先暴露的那道裂缝。
中国互联网络信息中心2025年发布的第56次《中国互联网络发展状况统计报告》的数据清晰显示:截至当年6月,全国60岁及以上老年网民约1.61亿人,虽然这一群体人数在近15年间增长约18倍,但仍有近半数老年人尚未真正进入数字生活;而在全国“非网民”群体中,60岁以上老人占比达52.1%,其中农村老年人为多。
即便已经接入网络的老人,也并非没有障碍。据新华网2025年的报道,82.9%的中老年网民存在不同程度的互联网使用障碍,70岁以上老人中这一比例接近88%;老人日均上网约3.3小时,低于全体网民的4.16小时。
把视野放到全球,国际电信联盟2026年发布的报告揭示了相似的规律:AI的使用率随年龄急剧下降,30至44岁为高峰,60岁以后明显走低;发达地区采用AI的速度约为发展中地区的两倍。年龄、性别、地域相互叠加,构成一层压一层的结构性劣势。AI并未凭空制造“谁更会用工具”的差别,而是把原本存在的年龄差、城乡差、国别差,逐一放大、摆到了台面之上。
而“摸得着AI”这件事本身,同样横着一道叫作成本的门槛。有行业观察者在盘点时列出一张价格表:豆包付费版本年费最高五千余元,阿里通义Pro版每月二百一十元、仍需抢购;海外的ChatGPT Plus每月一百四十美元,更高一档的Pro版高达一千四百美元。免费版本功能受限、速度受限、次数受限。算力与数据正在成为新的生产资料,资源集中在少数企业手中,普通用户只能以“租用”方式获得服务。
成本只是其中一半,另一半,是“敢不敢用”。前述82.9%的中老年网民,其障碍不止于视力或操作。深耕老年数字教育近十年的太原开放大学教师杨晓琴发现,不少老人采取“防御性上网”:一部手机不插卡,专门刷视频、看新闻;另一部插卡,只绑定小额银行卡,唯恐误触扣费,也怕被网络诈骗盯上。随着电信诈骗从“广撒网”转向AI加持的“精准围猎”,老年人的顾虑并非没有来由。
北京大学国家发展研究院教授雷晓燕团队基于中国健康与养老追踪调查的研究显示,将数字技术纳入多维贫困衡量后,农村与老年群体的贫困差距进一步扩大。“传统收入贫困已解决,但发展能力的贫困依然存在。”雷晓燕说。
门槛的两端,一边是资金与硬件,决定“买不买得起、用不用得上”;一边是意识与勇气,决定“敢不敢用、会不会用、遇到问题求助何人”。优势群体两端兼得,弱势群体两端皆缺——这正是“放大镜”真正放大的部分。
一场分层:AI先动了谁的奶酪
接入决定“摸不摸得到”,职场则回答“摸到之后,谁先感受到冲击”。
世界经济论坛2025年初发布的《未来就业报告》预计,到2030年,全球约22%的岗位将受到技术变革冲击,预计新增1.7亿个岗位,同时约9200万个岗位消失,净增7800万个。表面看是“有增有减”,细看则未必乐观。
麦肯锡的调研更为直接。2025年的一项调查显示,51%的企业表示,生成式AI降低了其对入门级岗位的需求。美国劳工统计局的数据亦印证这一趋势:2019至2025年间,美国23至27岁大学毕业生的失业率,从3.25%升至4.59%。另有研究引用薪资数据平台ADP的高频数据发现,受AI影响最为明显的行业中,职场新人的就业率相对下滑16%,而资深岗位大体保持稳定。
斯坦福大学数字经济实验室2026年的研究更进一步:在AI暴露度较高的职业中,22至25岁年轻人的就业水平,比同龄、低暴露度职业者低19%,且缺口仍在扩大,而主要原因并非来自裁员,而是来自“不再招聘”。
国际货币基金组织2025年的研究给出了一个比例:高AI暴露度的岗位,在发达经济体占60%,在新兴市场占42%,在低收入国家仅占26%。收入越高的经济体,认知型岗位越多,暴露于AI之下的就业人口也越多。
这些数据指向一个事实:AI最先冲击的,恰是最应给新人机会的“入门台阶”。
“AI教父”、诺贝尔奖得主杰弗里·辛顿的观点更为直接。他此前在接受《金融时报》采访时曾预测,“这会让少数人变得更富有,而大多数人则会更贫穷”;2025年接受媒体采访时又表示,“实际情况是,富人将使用人工智能来取代工人”。他多次提醒,AI正在压缩入门级岗位。
另一位从业者的观察,则揭示了差距被拉大的机制。2026年,美国人工智能企业Anthropic的首席经济学家麦克罗伊在一次关于AI未来的前瞻讨论中坦言,AI大概率会加剧资本与劳动力之间的不平等。他特别指出:“当你查看实际采用者的数据时,会发现其主要采用群体是高薪高技能的人才。”也就是说,AI最先赋能且赋能最多的,正是本已强大的群体——这也正是鸿沟被不断拉大的内在逻辑。
一代赛跑:教育会不会输在起跑线
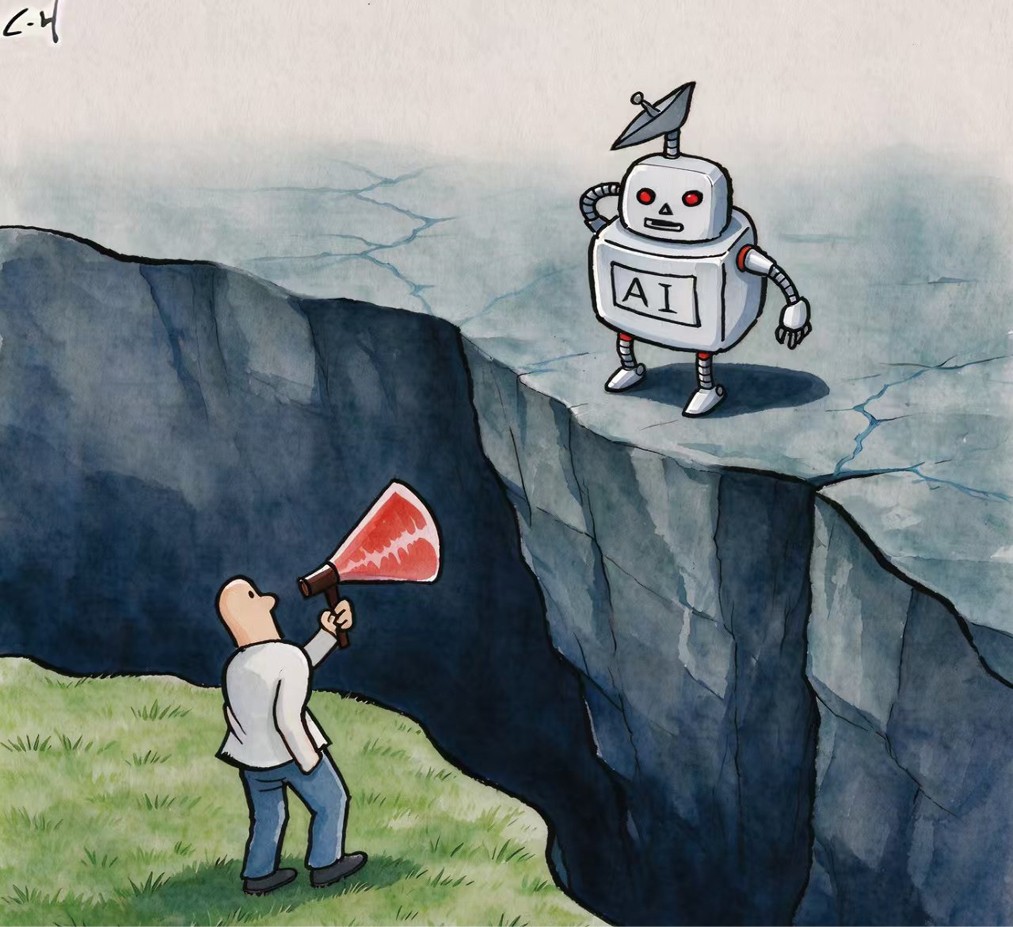
人类该如何填平AI时代的鸿沟?漫画/崔弘
AI带来的能力差距,最容易在下一代身上显现。这一棒若接不好,下一代的分化将被成倍放大。
官方层面已经在抢跑。2024年12月,教育部部署加强中小学人工智能教育,明确了各学段的侧重点:小学低年级侧重“感知和体验”,小学高年级和初中侧重“理解和应用”,高中侧重“项目创作和前沿应用”。2026年4月,教育部等五部门印发《“人工智能+教育”行动计划》,要求开齐开足开好人工智能课程、将AI教育全面纳入地方课程体系,并专门提出“支持农村、边远地区学校利用国家平台开好人工智能课程”。
城市与乡镇之间,差的并不只是一份政策文件,而是设备、师资、带宽,以及孩子接触AI的日常频率。当城市孩子将AI视为学习伙伴与思辨工具时,乡镇孩子可能一个学期也见不到几次真实应用。“AI素养”一旦成为新的基础能力,学校之间的资源差距,便可能被放得更大,而这正是教育必须回答的问题。
今年6月3日,中央网信办、教育部、工业和信息化部、人力资源社会保障部联合印发《2026年提升全民数字素养与技能工作要点》,部署6个方面15项重点任务,明确提出强化人工智能赋能教育、加快人工智能人才培育、深化人工智能普及应用等核心目标。这是继《“人工智能+教育”行动计划》之后,国家层面再次为AI与教育深度融合划定路线图。
2026年4月,雷晓燕在一次谈公益如何弥合技术鸿沟的主旨演讲时提醒,“教育滞后与贫富分化”是AI时代绕不开的挑战。而相对乐观之处在于,这恰是政策可以着力的环节——普惠的AI工具,加上系统的AI素养课程,是有可能将分化往回拉动的。
9月,2026华为坤灵新品发布会上,华为副总裁、ICT产品组合管理与解决方案部总裁马海旭发布了全新升级的智能教育场景方案,以智能互动教室与智联校园两大方案为抓手,给出了让智能教育规模化落地的可行路径。马海旭说,过去很多智能教室方案停留在设备堆叠层面,只是给教室加装了大屏、平板等硬件,却没有解决AI应用与教学流程脱节、算力支撑不足、交互体验不佳等问题。华为的坤灵智能互动教室方案可以轻松实现4K高清教学视频、VR沉浸式教学、AI实时互动等应用,目前已经打造了北京第十八中学、深圳外国语、德国纽伦堡学校等样板,助力全球3000多家教育机构加速迈向教育智能化。
一套工序:如何把鸿沟填平
个人层面的鸿沟是“会不会用”,到了国家与产业层面,便是“有没有得用”。
2025年10月,英伟达创始人黄仁勋在一次公开访谈中透露:受美国出口管制影响,英伟达在中国AI芯片市场的份额,“已经从95%降到了0”。份额归零的另一面,是中国在加快补课。IDC数据显示,2025年中国AI加速卡市场,本土厂商出货量约165万张,市场份额首次突破四成,华为昇腾以81.2万张居首。
当核心算力、算法与数据日益集中于少数企业,乃至少数国家,“供应链安全”便不再只是一句口号。2026年,摩根士丹利中国首席经济学家邢自强在一次关于AI经济影响的讨论中判断,全球不平衡在未来五到十年“有可能是加剧,而不是改善”——美国大举投资算力与前沿模型,或将进一步放大贫富分化。
不过,北京大学教授林毅夫近日在接受媒体采访时表示,与以往历次工业革命不同,这次前沿AI技术正通过开放系统变得触手可及,开源为全球南方提供了“新的后发优势”;同时他也带有些许紧迫感地指出:“如果全球南方抓不住人工智能机遇,不能将其应用于生产,南北发展鸿沟将会进一步拉大。”
AI的“放大”不是宿命,却确实在加速。谁先摸到、谁先用好、谁的下一代先学会,差距便在被同步放大。若放任自流,人与人的能力鸿沟、国与国的差距,大概率会持续拉大。但要填补鸿沟也并非无解,这需要的不是某一次发力,而是“降门槛、教素养、留退路、强治理”等一整套环环相扣的动作。
接入是起点,宽带要通、设备要够、服务要便宜。这几年国家层面的动作并不少:比如教育部《“人工智能+教育”行动计划》明确“支持农村、边远地区学校利用国家平台开好人工智能课程”;全国三千多家与老年人、残疾人生活密切相关的网站和App完成适老化改造……开源模型与普惠工具的普及,也让“用不起”这道门槛一点点变低。
门槛降下来之后,破解“会不会用、敢不敢用”,系统化的AI素养教育成为关键。它不应只是城市孩子的特权,而应成为面向全龄的公共课程。落到家庭与社区,“数字反哺”里子女当老师、父母当学生;一些地方探索的“时间银行”互助养老,让低龄老人与志愿者为高龄老人做智能手机教学……
填补AI鸿沟,不等于逼所有人跟上技术,更要尊重“跟不上的权利”。2025年,南开大学经济学院教授原新在接受新华社记者采访时打了一个比方:就像ETC普及之后,高速路口依然保留着人工通道。无论技术进化到何种程度,都应保留现金支付、人工窗口与面对面的温情——这套“人文备份系统”,平时是可选项,在有人被技术落下时,便是托底。
当算力、算法与数据日益集中,反垄断、多元供给与算法监管,是防止鸿沟演变为少数人垄断权力游戏的防线;当社会的选择权与责任逐渐交给黑箱,保留人的判断与“打破常规”的能力,是守住整个体系韧性的底线。
能力鸿沟会不会越拉越大,并不取决于AI本身,而取决于社会的选择。这不是一个技术命题,而是一道关于公平的取舍题。记者|刘朝晖
链接:我国生成式人工智能用户规模突破7亿人!
9月29日,中国互联网络信息中心政策与国际合作所发布《生成式人工智能应用发展报告(2026)》(以下简称《报告》),《报告》显示,截至2026年上半年,我国生成式人工智能用户规模突破7亿人,普及率超50.0%。
从各类生成式人工智能应用的用户使用次数来看,AI综合助手、AI效率办公等应用的使用次数同比增长均超过100%。
截至2026年6月,我国智能算力规模达2185EFLOPS(百亿亿次浮点运算/秒),同比增长177%;首个全国产10万卡人工智能超集群正式投用,在芯片、计算、存储、网络、散热等核心软硬件均采用国产自主可控技术,实现了从底层硬件到上层服务的全栈国产化,标志着我国算力基础设施建设迈入十万卡级部署新阶段。
深度求索、月之暗面等本土企业先后发布多个万亿级参数开源大模型,全球主流大模型调用榜单上排名前六的模型全部来自中国团队,国产模型与国产算力芯片加速适配。
我国已建成高质量数据集超过12万个,加速形成算力、模型、数据互促共进的良性循环。
本平台所发布信息的内容和准确性由提供消息的原单位或组织独立承担完全责任。
